 2021, Vol. 43


在现代智能交通系统中,交通流分析已成为一个重要的组成部分。在这方面先前已经有了大量的研究工作[1-5],而其中值得关注的是交通指数云图这一种创新的宏观交通流分析方法。交通指数云图的灵感来源于气象云图,它关注的是区域的宏观交通状态,而不是中观分析中的道路状态或微观分析中的车辆状态。在交通指数云图中,一张城市路网被划分为若干网格,每个网格都可视为一个小区域,通过获取区域中所有道路的相关信息,再利用交通指数公式就能生成相应区域的交通指数。交通指数可以反映区域的交通状态,为了可视化的方便,交通指数在云图上被映射为不同的颜色,例如,红色表示一个区域是拥堵的,绿色表示一个区域是畅通的。完整的交通指数云图对于交通分析很有帮助,然而在某些情况下,由于计算交通指数的相关数据的丢失,导致了某些区域交通指数的缺失。这些缺失不具有规律性,从而对宏观交通流分析产生了阻碍。因此,本文的目标就是从时间和空间的角度出发,对区域交通指数进行预测分析。
交通流分析中的预测方法大致可分为两类:时间序列分析方法和机器学习方法[6]。自回归移动平均(ARIMA)模型是时间序列分析方法的典型代表,它通常用于规律性的交通流量预测[7]。这种类型的模型试图建立一种数学算法,以规则的时间间隔解释一系列过去的行为,然后将其应用于预测未来的值[8-9]。该模型适用于挖掘出交通流在时间上的变化规律。
支持向量机(SVM)作为一种著名的机器学习方法,具有良好的自学习和非线性预测能力,在实时交通流预测中具有显著的优势[10-11]。交通流在短时间内可能出现不规律的变化,而SVM模型正适合捕获这种变化。除此之外,即使在训练样本有限的情况下,它仍然可以获得相对更好的预测结果。因此,该模型适用于实时预测系统[12]。
有关时间序列的研究中,ARIMA及其季节性模型SARIMA已被广泛用于交通流预测中。例如,Xu等[13]使用ARIMA和Kalman滤波器来预测实时道路交通状态,Luo等[14]提出了一种基于改进的SARIMA和遗传算法的交通流预测算法。他们改进了原始的ARIMA模型并获得了令人满意的结果,这证明ARIMA模型从时间的角度出发的确解决了一些交通预测的问题。但是,作为一种线性模型,其在处理非线性的问题上表现并不好。
SVM是一种基于结构风险最小化原则的机器学习方法,也属于非参数化模型的代表[15]。机器学习方法在交通上的应用已经越来越受到学者的关注,而SVM模型正是其中表现良好的一种方法[16-17]。SVM的分类模型SVC常被用于车辆的分类检测或是道路的交通分析[18-19],而回归模型SVR常被用于交通流的预测分析[20-21]或是交通事故的防范预警[22-23]。SVM模型之所以得到学者的关注,一方面是由于本身的精度较高,另一方面也是因为其处理交通非线性问题的能力优异。以交通流为例,交通流在一个短期时间内可能呈现出许多不规律的变化特性,对这部分的预测也具有难度。传统线性预测模型不仅需要大量的历史数据,并且预测的效果可能也不尽如人意。相比之下,SVM模型所需的训练数据较少,并且在这种短期非线性的预测问题上效果更好。
考虑到本文的区域交通状态预测不同于现有大量研究中的中微观交通流预测,在这种宏观层面的研究较少,并且区域的交通状态是复杂的,总体既在时间上呈现出一定规律性的变化,局部又在空间上表现出一种不规律的分布特点。因此,如何定量分析交通状态并进行状态预测是本文的核心。受前人研究的启发,本文在城市交通状态指数的基础上,同时从时间与空间两个角度进行状态预测,并基于两者的预测结果,尝试构建出一个集成模型,进一步提高预测精度。
1 交通指数及交通指数云图交通指数TI是衡量一个区域交通状态的指标,取决于区域内的路段信息、路网信息以及时间等因素,其计算公式为[4]
| $ TI = \left[ {\frac{{\displaystyle\sum\limits_{r = 1}^R {{P_r}} \left( {\sum\limits_{t = 1}^T {{w_t}} \left( {\sum\limits_{i = 1}^N {{k_i}{l_i}\frac{{{V_i}}}{{{V_{{\rm{f}}r}}}}} } \right)} \right)}}{{\displaystyle\sum\limits_{r = 1}^R {{P_r}\left( {\sum\limits_{t = 1}^T {{w_t}} \left( {\sum\limits_{i = 1}^N {{k_i}{l_i}} } \right)} \right)} }}} \right] \times 100 $ | (1) |
式中:
单纯的交通指数不能直观地呈现区域的交通状态,因此,需要交通指数云图(TICM)这样的可视化工具。TICM由交通速度云图改进而来[24],其具体生成步骤如下:
a. 将整个城市地图划分成若干
b. 根据交通指数公式计算各网格的指数值,值越小表示区域越拥挤,值越大表示区域越畅通;
c. 为了可视化交通指数值,使用了一系列颜色将指数值映射到TICM上,例如,绿色表示区域畅通,黄色表示区域拥挤,红色表示区域堵塞;
d. 选定划分数目n和时间段,就可以获得最终的TICM。
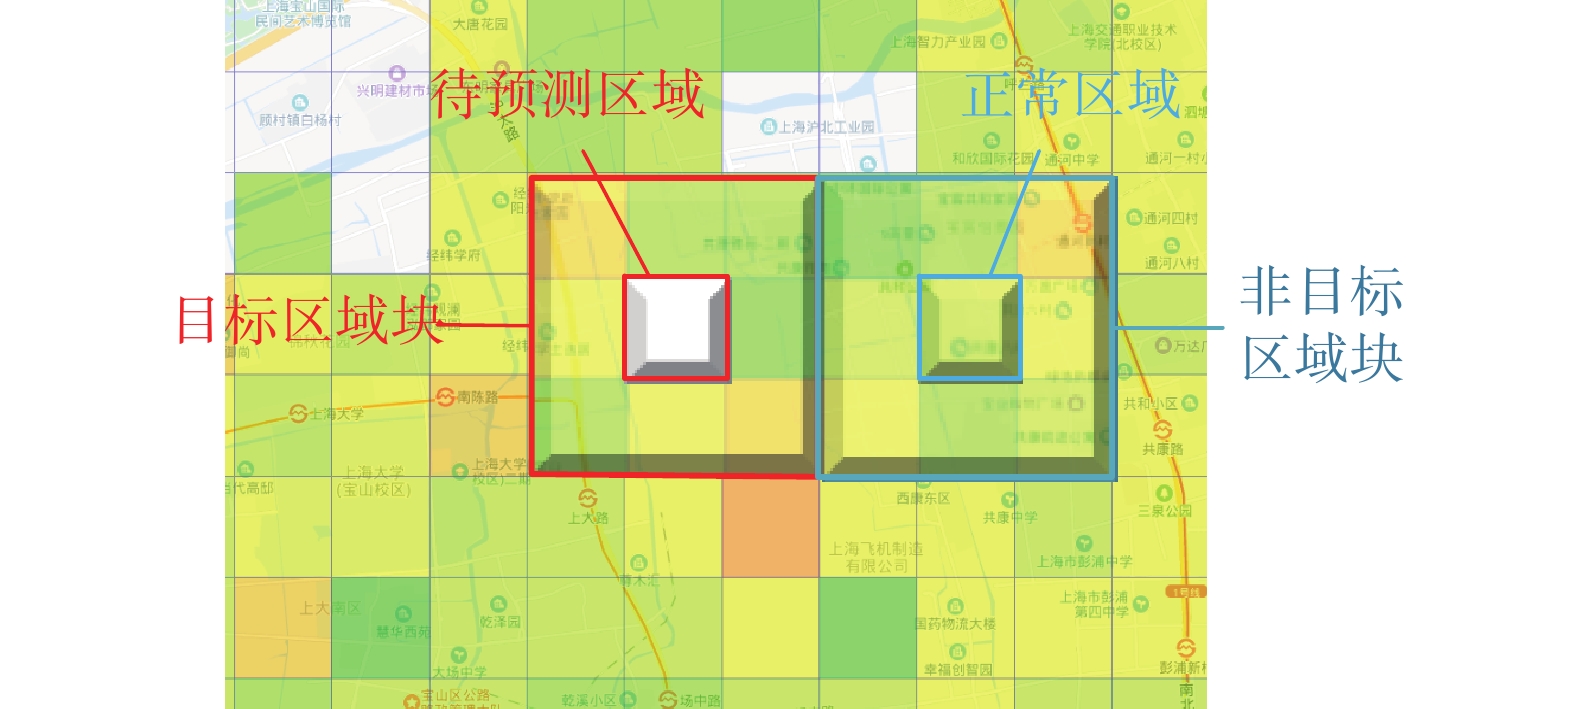
TICM中指数值的缺失大部分是由于某段时间内某些路段原始交通数据的缺失导致,通常在时间上表现为一段10~20 min的数据空白,并且在凌晨至中午的时间段内出现的频率较高;在空间上表现为缺失值的区域分布零散,夹杂在正常区域之中。为了从空间角度研究区域特性,将缺失值的区域连同其周围8个区域划分在一起,这样一个3×3的大区域称之为区域块。对于其他的正常区域,也可以作这样的区域块划分,目的是为了之后训练模型的需要。根据区域块的中心区域是否有指数值,可以将区域块划分为包含待预测区域的目标区域块和非目标区域块,其示例图如图1所示。
|
图 1 目标区域块和非目标区域块示例 Fig. 1 An example of a target block and a non-target block |
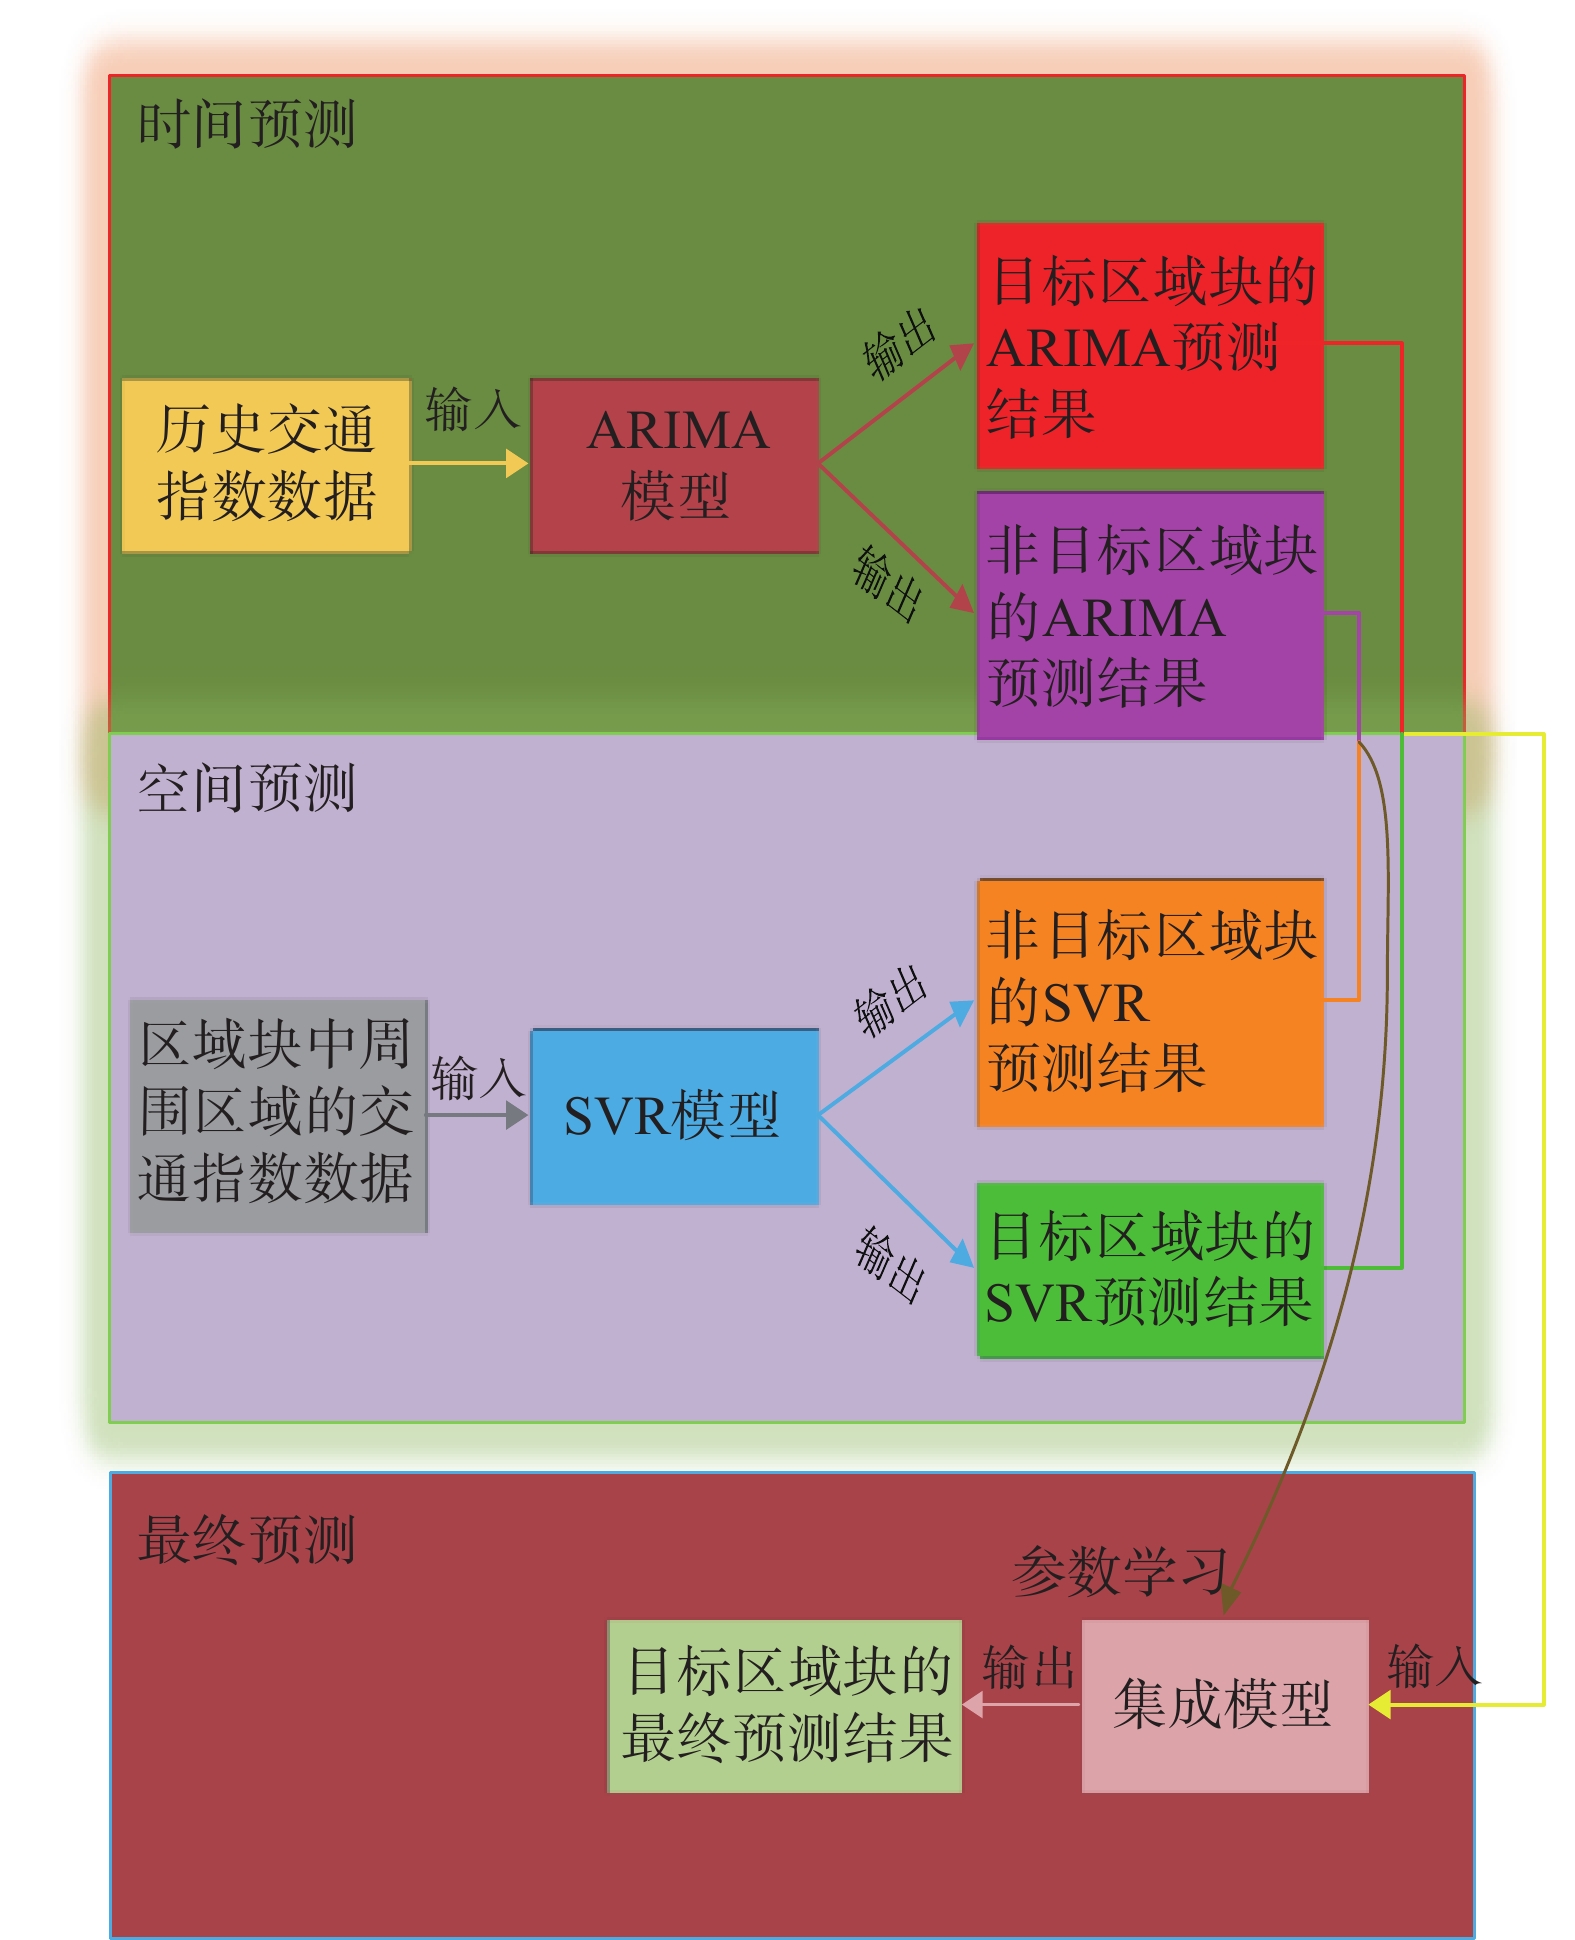
基于区域块划分和时空结合预测的思想,构建出区域交通状态指数预测的框架,如图2所示。
|
图 2 方法框架图 Fig. 2 Framework of proposed model |
方法框架主要由3个部分组成:时间预测部分、空间预测部分和最终预测部分。目标区域块在时间和空间预测部分的结果将被输入到集成模型中,而非目标区域块的时空预测结果将被用于训练和学习集成模型的参数,两者共同获得最终的预测结果。
在时间预测部分,使用ARIMA模型基于之前的历史数据进行预测。由于不同区域的状态变化情况都不尽相同,因此,需要对每个区域建立唯一的ARIMA模型。
在空间预测部分,需要挖掘中心区域与其周围区域空间上的关系。这种空间联系不像时间那样呈现出一定的规律性,因此,很难用线性模型加以描述。本文采用SVR模型来进行空间预测,非目标区域块的数据将作为训练集用来进行SVR模型的训练和参数学习。
2.2 时间ARIMA模型与空间SVR模型ARIMA模型是描述时间序列的模型,它由3个部分组成,分别是自回归(AR)部分、积分(I)部分和移动平均值(MA)部分。其中,AR部分描述了当前值和历史值之间的关系,I部分使采样时间序列满足平稳性的要求,MA部分描述了模型中误差的积累[25]。在本文中,假设区域在
| $ {y_t} = \mu + \sum\limits_{i = 1}^p {{\lambda _i}{y_{t - i}}} + {e_t} - \sum\limits_{i = 1}^q {{\theta _i}{e_{t - i}}} $ | (2) |
式中:
对于每一个区域,都可以通过式(2)获得ARIMA的预测结果。在每一个区域块中,本文主要关注中心区域的预测结果,并将待预测区域的预测值记为
SVR模型的空间预测主要以区域块为单位。假设第
| $ \left\{ {({{\boldsymbol{x}}_1},{y_1}),({{\boldsymbol{x}}_2},{y_2}),\cdots,({{\boldsymbol{x}}_i},{y_i}),\cdots,({{\boldsymbol{x}}_n},{y_n})} \right\} $ | (3) |
其中,
SVR模型的决策函数
| $ f({\boldsymbol{x}}) = {{\boldsymbol{\omega}} ^{\rm{T}}}\varphi ({\boldsymbol{x}}) + b $ | (4) |
式中:
模型的任务首先是参数学习,即解决如下所示的最优化问题:
| $ \mathop {\min }\limits_{{\boldsymbol{\omega}} ,b} \ \frac{1}{2}||{\boldsymbol{\omega}} |{|^2} + C\sum\limits_{i = 1}^n {{l_\varepsilon }} (f({{\boldsymbol{x}}_i}) - {y_i}) $ | (5) |
式中:
| $ {l_\varepsilon }(\sigma ) = \left\{ \begin{array}{*{20}{l}} 0,&|\sigma | \leqslant \varepsilon\\ |\sigma | - \varepsilon ,& \text{其他} \end{array} \right. $ | (6) |
式中:
通过引入松弛变量
| $ \mathop {\min }\limits_{{\boldsymbol{\omega}} ,b} \ \frac{1}{2}||{\boldsymbol{\omega}} |{|^2} + C\sum\limits_{i = 1}^n {({\xi _i}} + \hat{\xi} _i) $ | (7) |
| $ {\rm{s.t.}}\left\{ {\begin{array}{*{20}{l}} {f({{\boldsymbol{x}}_i}) - {y_i} \leqslant \varepsilon + {\xi _i}} \\ {{y_i} - f({{\boldsymbol{x}}_i}) \leqslant \varepsilon + {\hat{\xi}_i}} \\ {{\xi _i} > 0,\;\;{\hat{ \xi }_i} > 0,\;\;i = 1,2,3,\cdots,n} \end{array}} \right. $ | (8) |
直接根据式(8)的约束条件对式(7)进行求解是很困难的,通常的做法是引入拉格朗日乘子
| $ {\boldsymbol{\omega }} = \sum\limits_{i = 1}^n {({{\widehat {\boldsymbol{\alpha}} }_i}} - {{\boldsymbol{\alpha }}_i})\varphi ({{\boldsymbol{x}}_i}) $ | (9) |
将式(9)代入式(4),并且在处理拉格朗日乘数问题的必要条件(KKT条件)下[26],可以得到决策函数的最终形式:
| $ f({\boldsymbol{x}}) = \sum\limits_{i = 1}^n {({{\widehat {\boldsymbol{\alpha}} }_i}} - {{\boldsymbol{\alpha}} _i})K({\boldsymbol{x}},{{\boldsymbol{x}}_i}) + b $ | (10) |
式中:
在本文中选择了径向基核函数,它的形式为
| $ K({\boldsymbol{x}},{{\boldsymbol{x}}_i}) = \exp ( - \gamma ||{\boldsymbol{x}} - {{\boldsymbol{x}}_i}|{|^2}) $ | (11) |
对于每一个区域块,可以根据式(10)计算出中心区域的空间预测结果,并将待预测区域的预测值记为
ARIMA模型的预测结果从时间规律性上描述了区域可能的状态,SVR模型的预测结果从空间非线性的关系中描述了区域可能的状态。但是,后续的实验部分证明,这两种模型各自的预测精度都不是很高,各有其优点和缺陷。因此,如何考虑时空相关性,以合适的方式将两者的结果进行组合与优化,是构建集成模型的关键。
在本文中,假设最终预测值是时间预测和空间预测结果的线性组合,即赋予时间和空间各一个权重,权重和为1,以此来反映时间和空间对最终预测值的贡献程度。假设第
| $ y_{{T_k}}^{\rm{F}} = \eta y_{{T_k}}^{\rm{S}} + (1 - \eta )y_{{T_k}}^{\rm{A}} $ | (12) |
式中,
对于
基于交通云图本身的特点,本文提出了一种利用非目标区域块来学习参数的自适应方法。对于第
| $ y_{{N_i}}^{\rm{F}} = \alpha y_{{N_i}}^{\rm{S}} + (1 - \alpha )y_{{N_i}}^{\rm{A}} $ | (13) |
由于此区域为正常区域,真实值是已知的,因此,可以判断预测结果与真实值之间的偏差。对于参数
| $ \varDelta = \frac{{|y_{{N_i}}^{\rm{F}} - {y_{{N_i}}}|}}{{{y_{{N_i}}}}} $ | (14) |
式中,
为了表示所有非目标区域块预测结果的偏差情况,计算相对误差的平均值
| $ {\overline y _\alpha } = \frac{{\displaystyle\sum\limits_{i = 1}^n {\frac{{|y_{{N_i}}^{\rm{F}} - {y_{{N_i}}}|}}{{{y_{{N_i}}}}}} }}{n} $ | (15) |
式中,
对于取不同值的
由于非目标区域块与目标区域块来自同一个交通指数云图,它们之间的时空关系近似相同,因此,通过非目标区域块的预测结果学习出最优的参数
算法1 集成模型的参数学习过程。
输入:参数
输出:参数
a. 令
b. 通过式(15)计算出平均相对误差
c. 令
d. 画出
为了评价模型的性能,在TICM平台上进行了实验。之前提到,时间上缺失值的产生多出现在凌晨和上午的时间段。同时,从实验结果验证的角度考虑,需要待预测区域有真实值进行对比。因此,选取了缺失值较少的一天的凌晨至中午时间段的数据,时间跨度为0:00—12:00,数据获取的时间间隔为10 min,并进行了数据清洗与预处理的工作。为了更好地区分时段的特性,将整个时间划分为0:00—6:00和6:00—12:00这2个时间段,并且假定每个时间段最后1 h的数据是缺失的。
在空间方面,所用的TICM以上海市区为背景,尺寸为48×48大小,共2304个区域。对TICM进行之前所述的区域块划分操作,并剔除异常和无效数据后,总共有211个区域块。将目标区域块和非目标区域块以3∶7的比例划分,共得到64个目标区域块和147个非目标区域块。
3.2 评价指标本实验中,选用预测分析中常用的3个评价指标:平均绝对误差(MAE)、均方根误差(RMSE)和平均绝对百分率误差(MAPE),用于评估时间预测模型、空间预测模型和集成模型的性能。评价指标的值越低,说明模型的性能越好[12]。
| $ MAE = \frac{1}{n}\sum\limits_{i = 1}^n {| {{\hat{y}_i}} } - {y_i}| $ | (16) |
| $ RMSE = \sqrt {\frac{1}{n}\sum\limits_{i = 1}^n {( {{\hat{y}_i}} } - {y_i}{)^2}} $ | (17) |
| $ MAPE = \frac{1}{n}\sum\limits_{i = 1}^n {\left| {\frac{{{{ {\hat{y}_i}}} - {y_i}}}{{{y_i}}}} \right|} \times 100\text{%} $ | (18) |
式中:
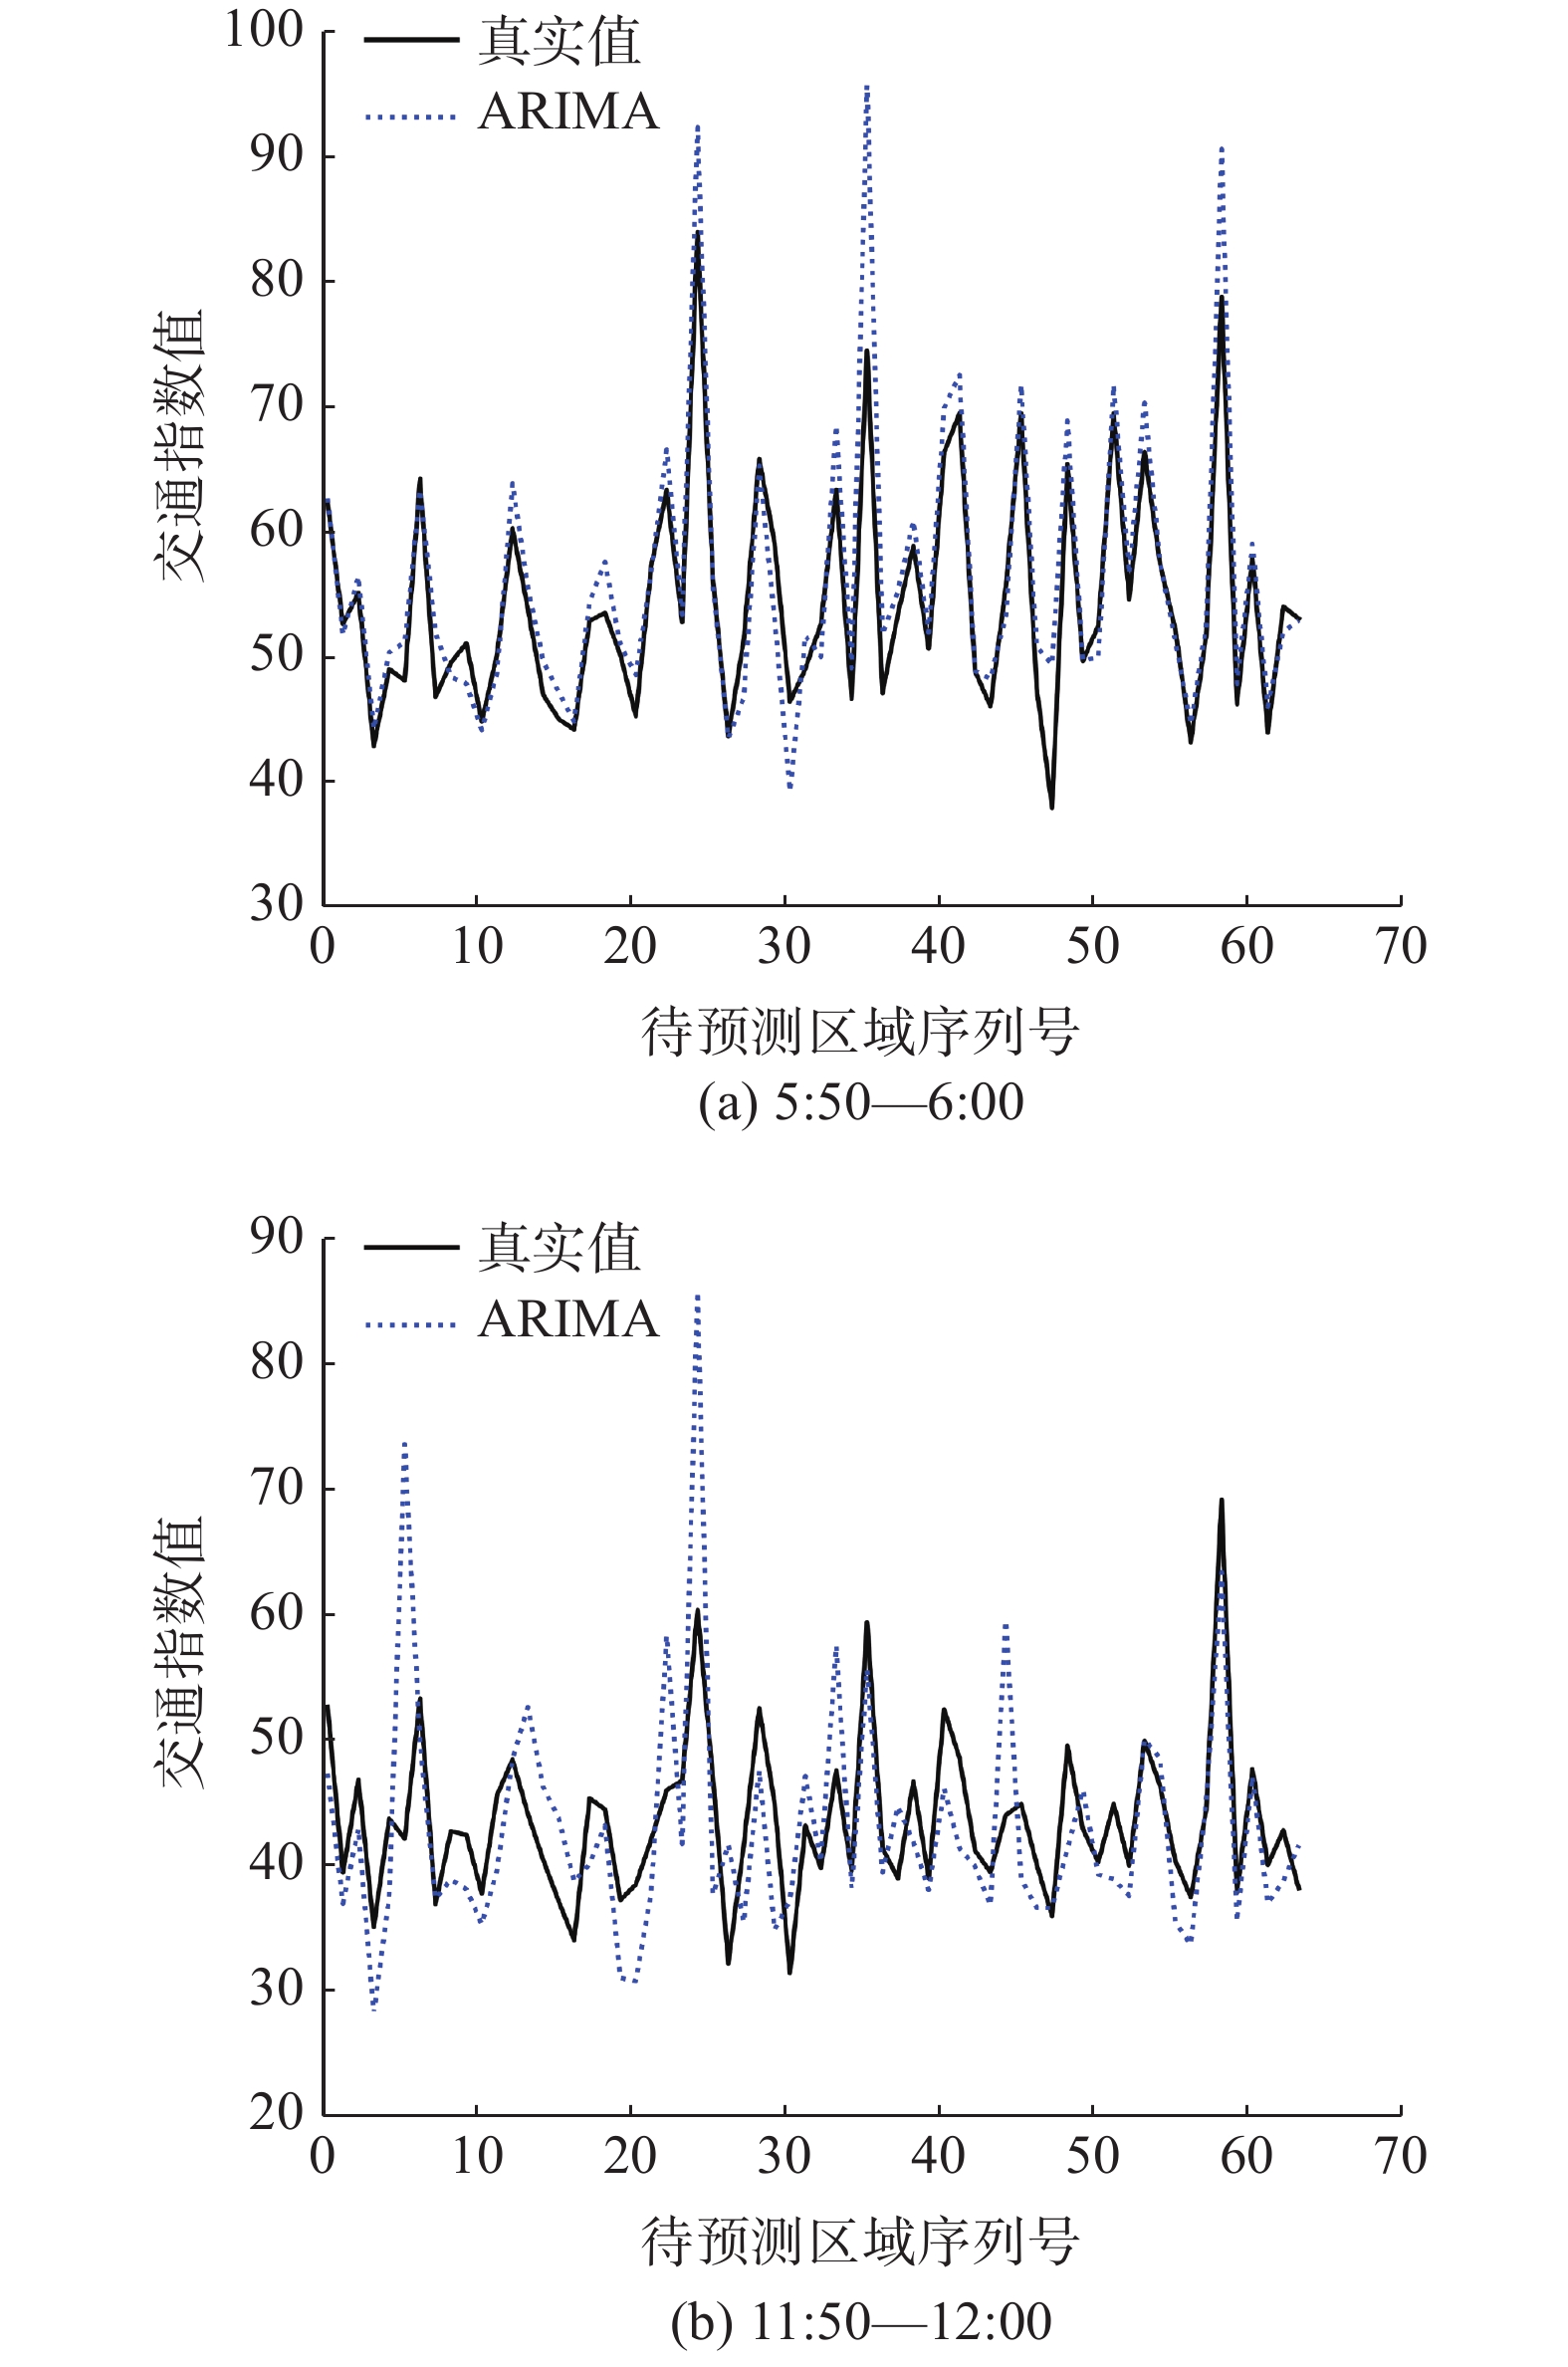
在时间预测部分,需要通过ARIMA模型预测每个时间段最后1 h的缺失值。值得注意的是,作为一种基于历史值的预测模型,ARIMA在离真实历史值较近的几个时间点,预测结果通常是比较好的,但是,模型性能会随着时间的增加而下降。通过ARIMA预测结果和真实值的对比,发现1 h中前20 min的ARIMA预测结果可近似认为达到了期望水平,但是,之后的结果则越来越不理想。因此,实验部分着重关注了每个时间段中模型表现最差的最后1个时间间隔,即5:50—6:00和11:50—12:00。对于64个目标区域块中的待预测区域,ARIMA的预测值和真实值的对比如图3所示。
|
图 3 ARIMA预测值和真实值的对比 Fig. 3 Comparison between the predicted value of ARIMA and true value |
可以看出,ARIMA模型预测值的变化趋势与真实值基本相同,但是,一些地方出现了很大的偏差。这一方面可能是由于某个时间交通流的剧烈变化,例如,早高峰,对模型产生了干扰;另一方面,也是受限于模型本身的学习和预测能力,导致总体的预测精度不高。
3.3.2 空间预测部分在空间预测部分,需要考虑区域块中心区域与周围区域的关系,对于SVR模型来说,就是目标与特征之间的关系。最直接的方法是将所有周围区域都作为特征输入,但是,结果证明并不是特征越多越好,特征间可能产生相互干扰,反而降低了模型预测的准确性。
通过借鉴现有的相关研究结果,使用随机森林的方式来对模型进行特征选择[27-28]。对于周围区域组成的一个特征集
|
表 1 随机森林方法得到的特征重要度 Table 1 Feature importance calculated by Random Forest |
可以看到,
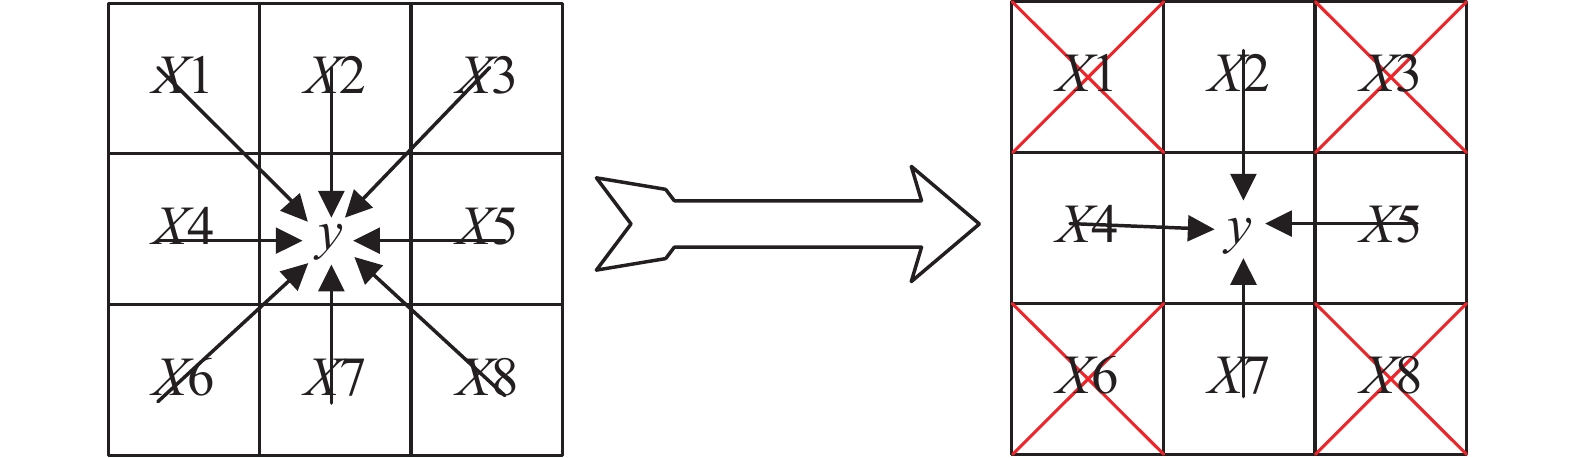
|
图 4 用随机森林进行特征选择 Fig. 4 Feature selection by Random Forest |
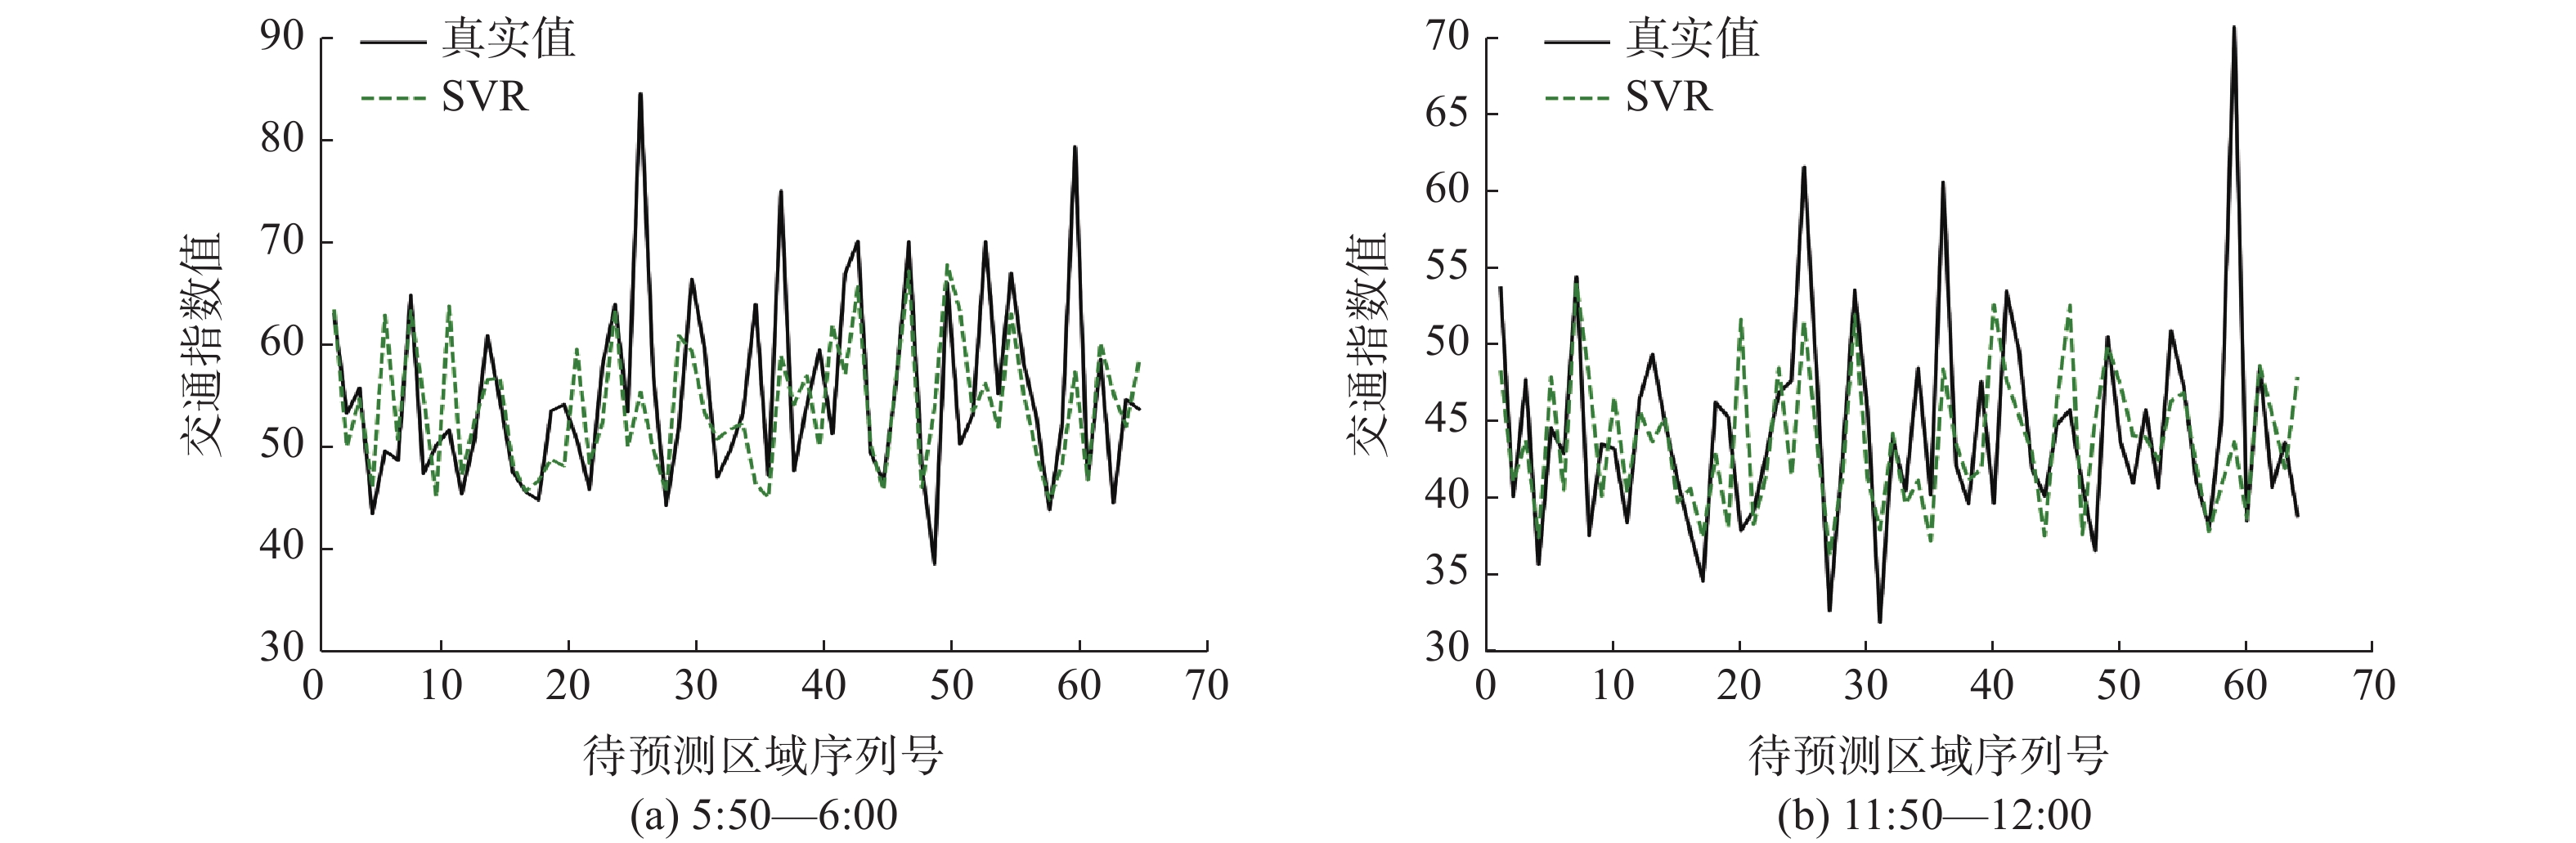
经过特征选择后,使用SVR模型对待预测区域进行预测,得到的预测值和真实值的对比如图5所示。可以看出,SVR模型的预测值变化较为平稳,但对于其中的峰值,SVR显然没有捕获到这种变化。结合之前ARIMA预测的结果来看,这些区域可能产生了指数值的突变,并且与其周围区域的联系不是很紧密,因此,用SVR模型很难准确预测。
|
图 5 SVR预测值和真实值的对比 Fig. 5 Comparison between the predicted value of SVR and true value |
虽然ARIMA模型和SVR模型各自的预测结果都不是很让人满意,但从上面的结果图中可以看到,两者的结果形成了一些互补,尤其是对于几个峰值点,ARIMA模型对变化的幅度产生了过量的预测,而SVR模型则对变化的预测不足。如果可以找到一种方法来衡量模型在不同时刻的表现,并设置合适的权重系数,那么,这样构建的集成模型应该可以有效提升预测准确性。
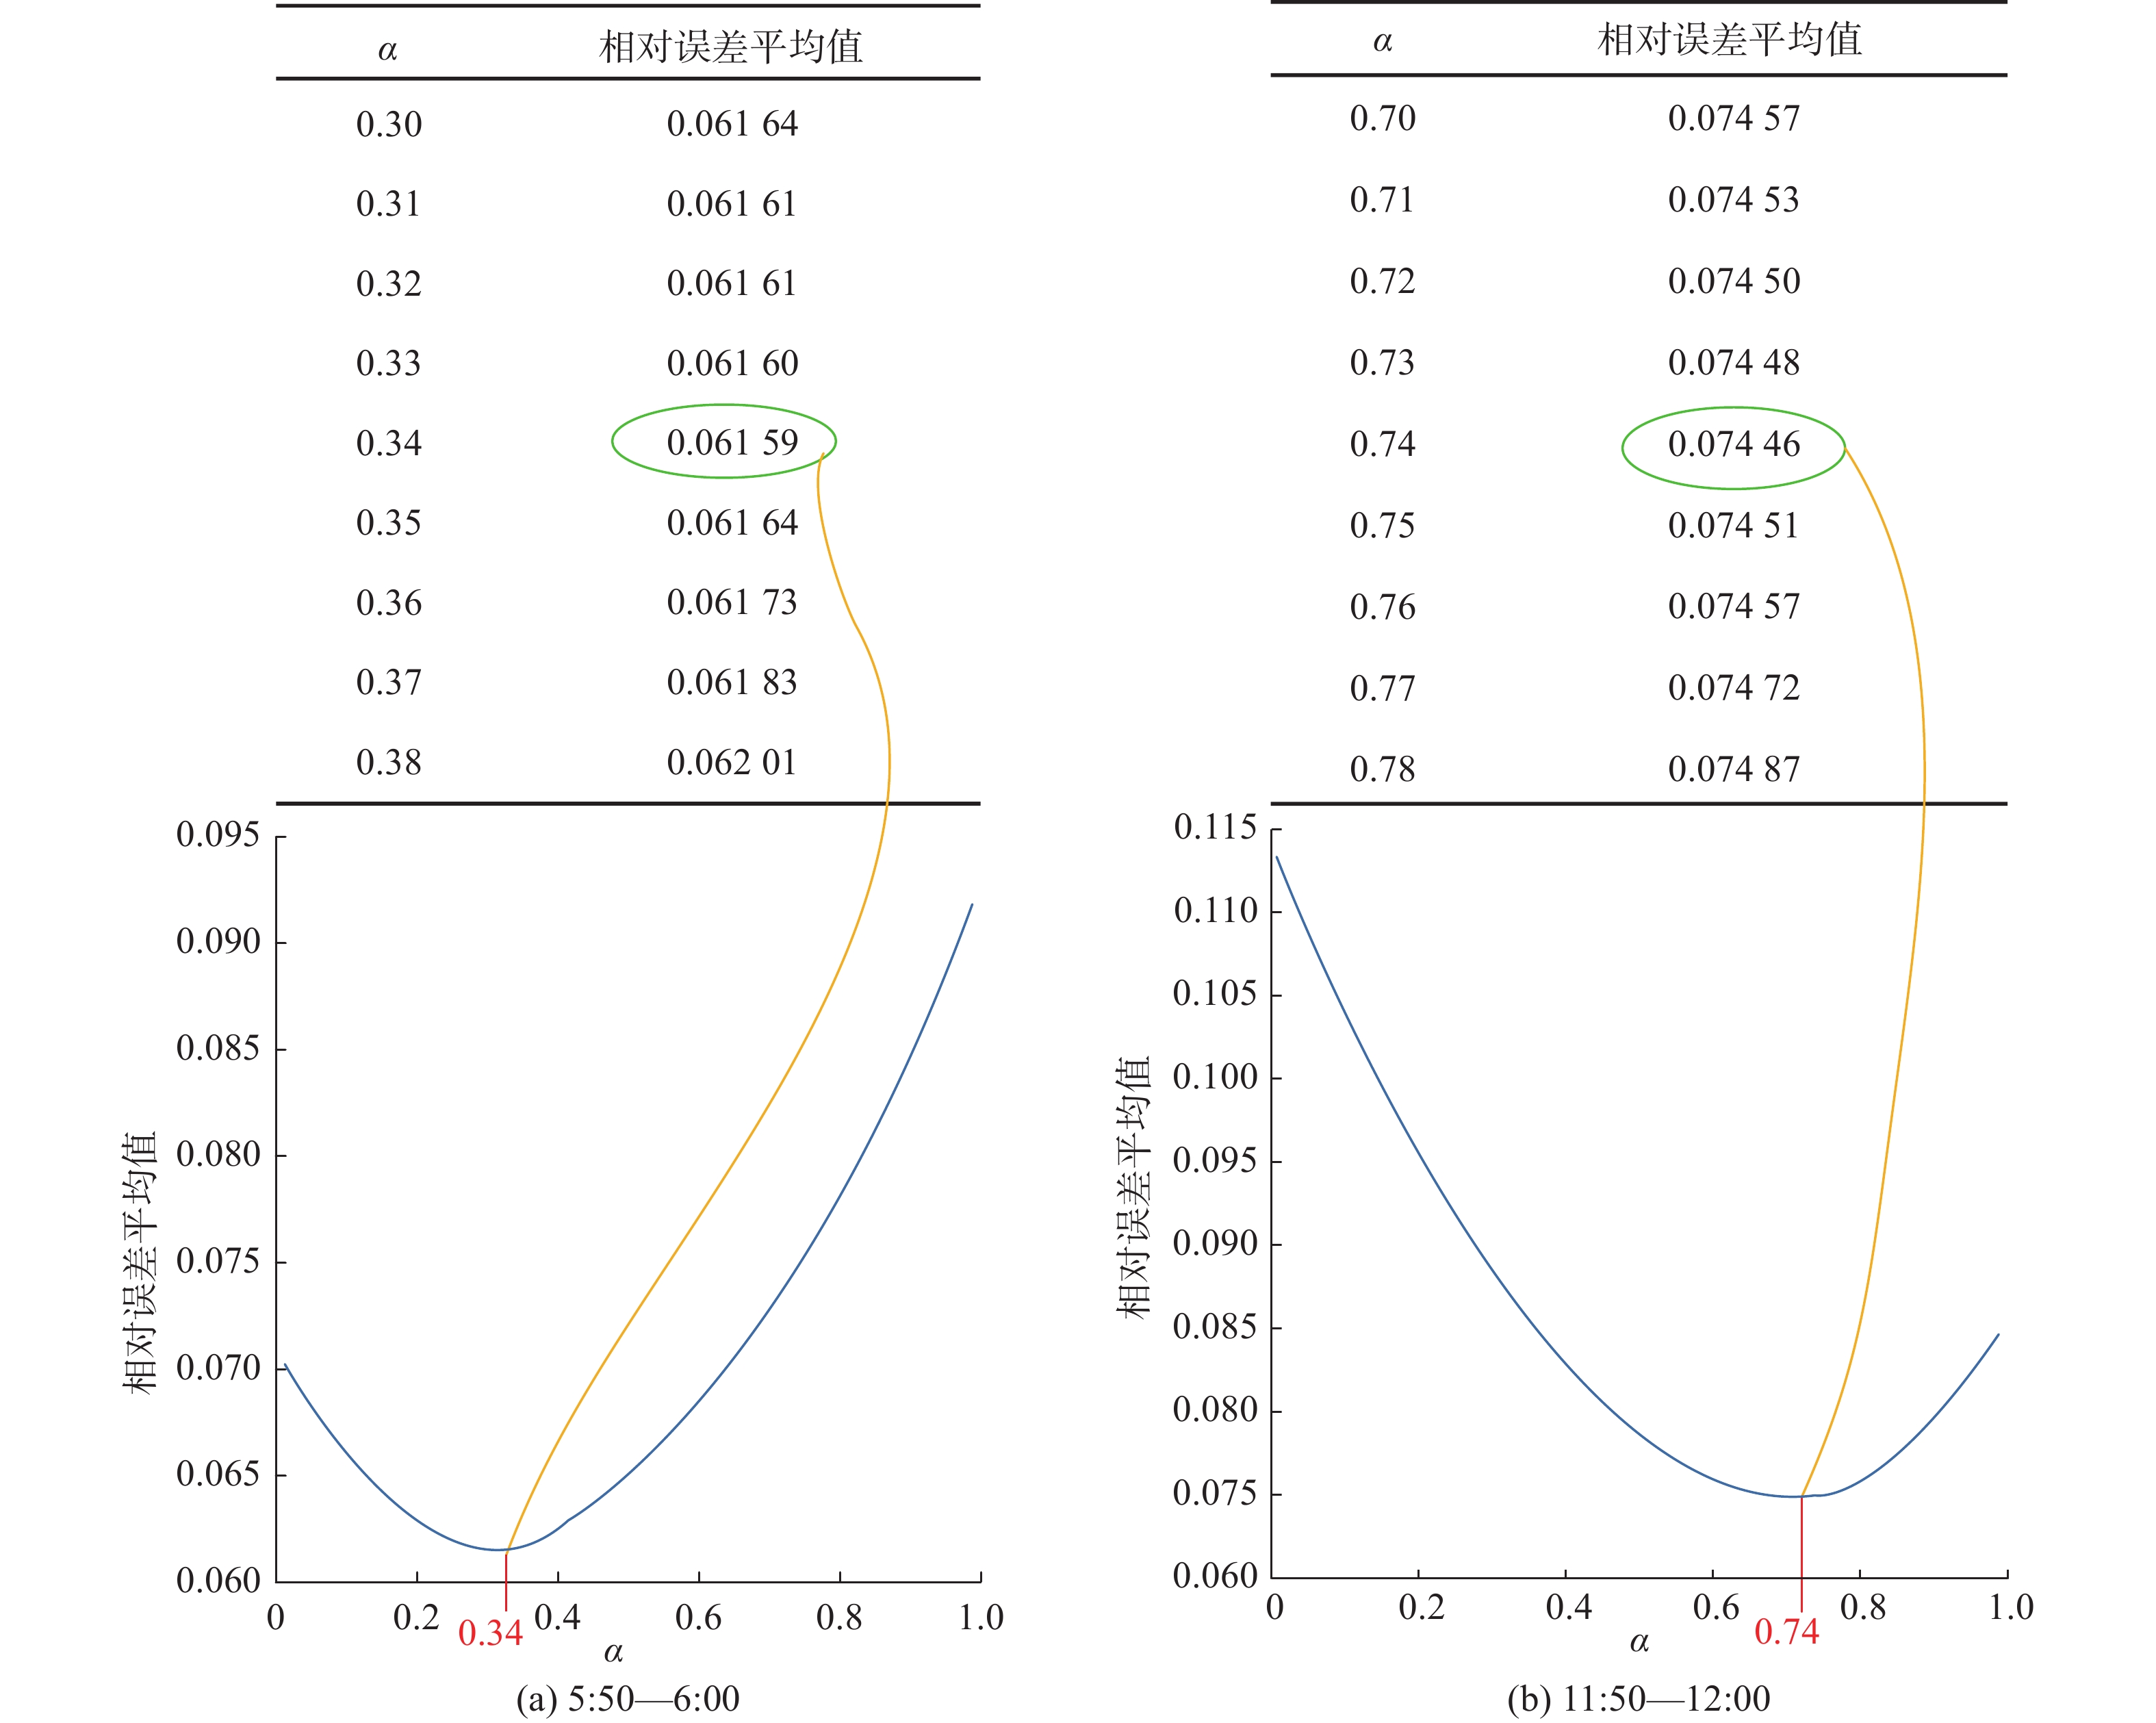
基于这样的思想,在方法部分详述了集成模型的构建过程。具体地,对于5:50—6:00和11:50—12:00这2个时间段,集成模型参数
|
图 6 集成模型参数确定过程 Fig. 6 Parameter determination of the integrated model |
| $ y_{{T_k}}^{\rm{F}} = 0.34y_{{T_k}}^{\rm{S}} + 0.66y_{{T_k}}^{\rm{A}} $ | (19) |
| $ y_{{T_k}}^{\rm{F}} = 0.74y_{{T_k}}^{\rm{S}} + 0.26y_{{T_k}}^{\rm{A}} $ | (20) |
式(19)代表5:50—6:00时间段的模型,式(20)代表11:50—12:00时间段的模型。可以看出在2个不同的时间段,模型训练得到的参数相差很大。
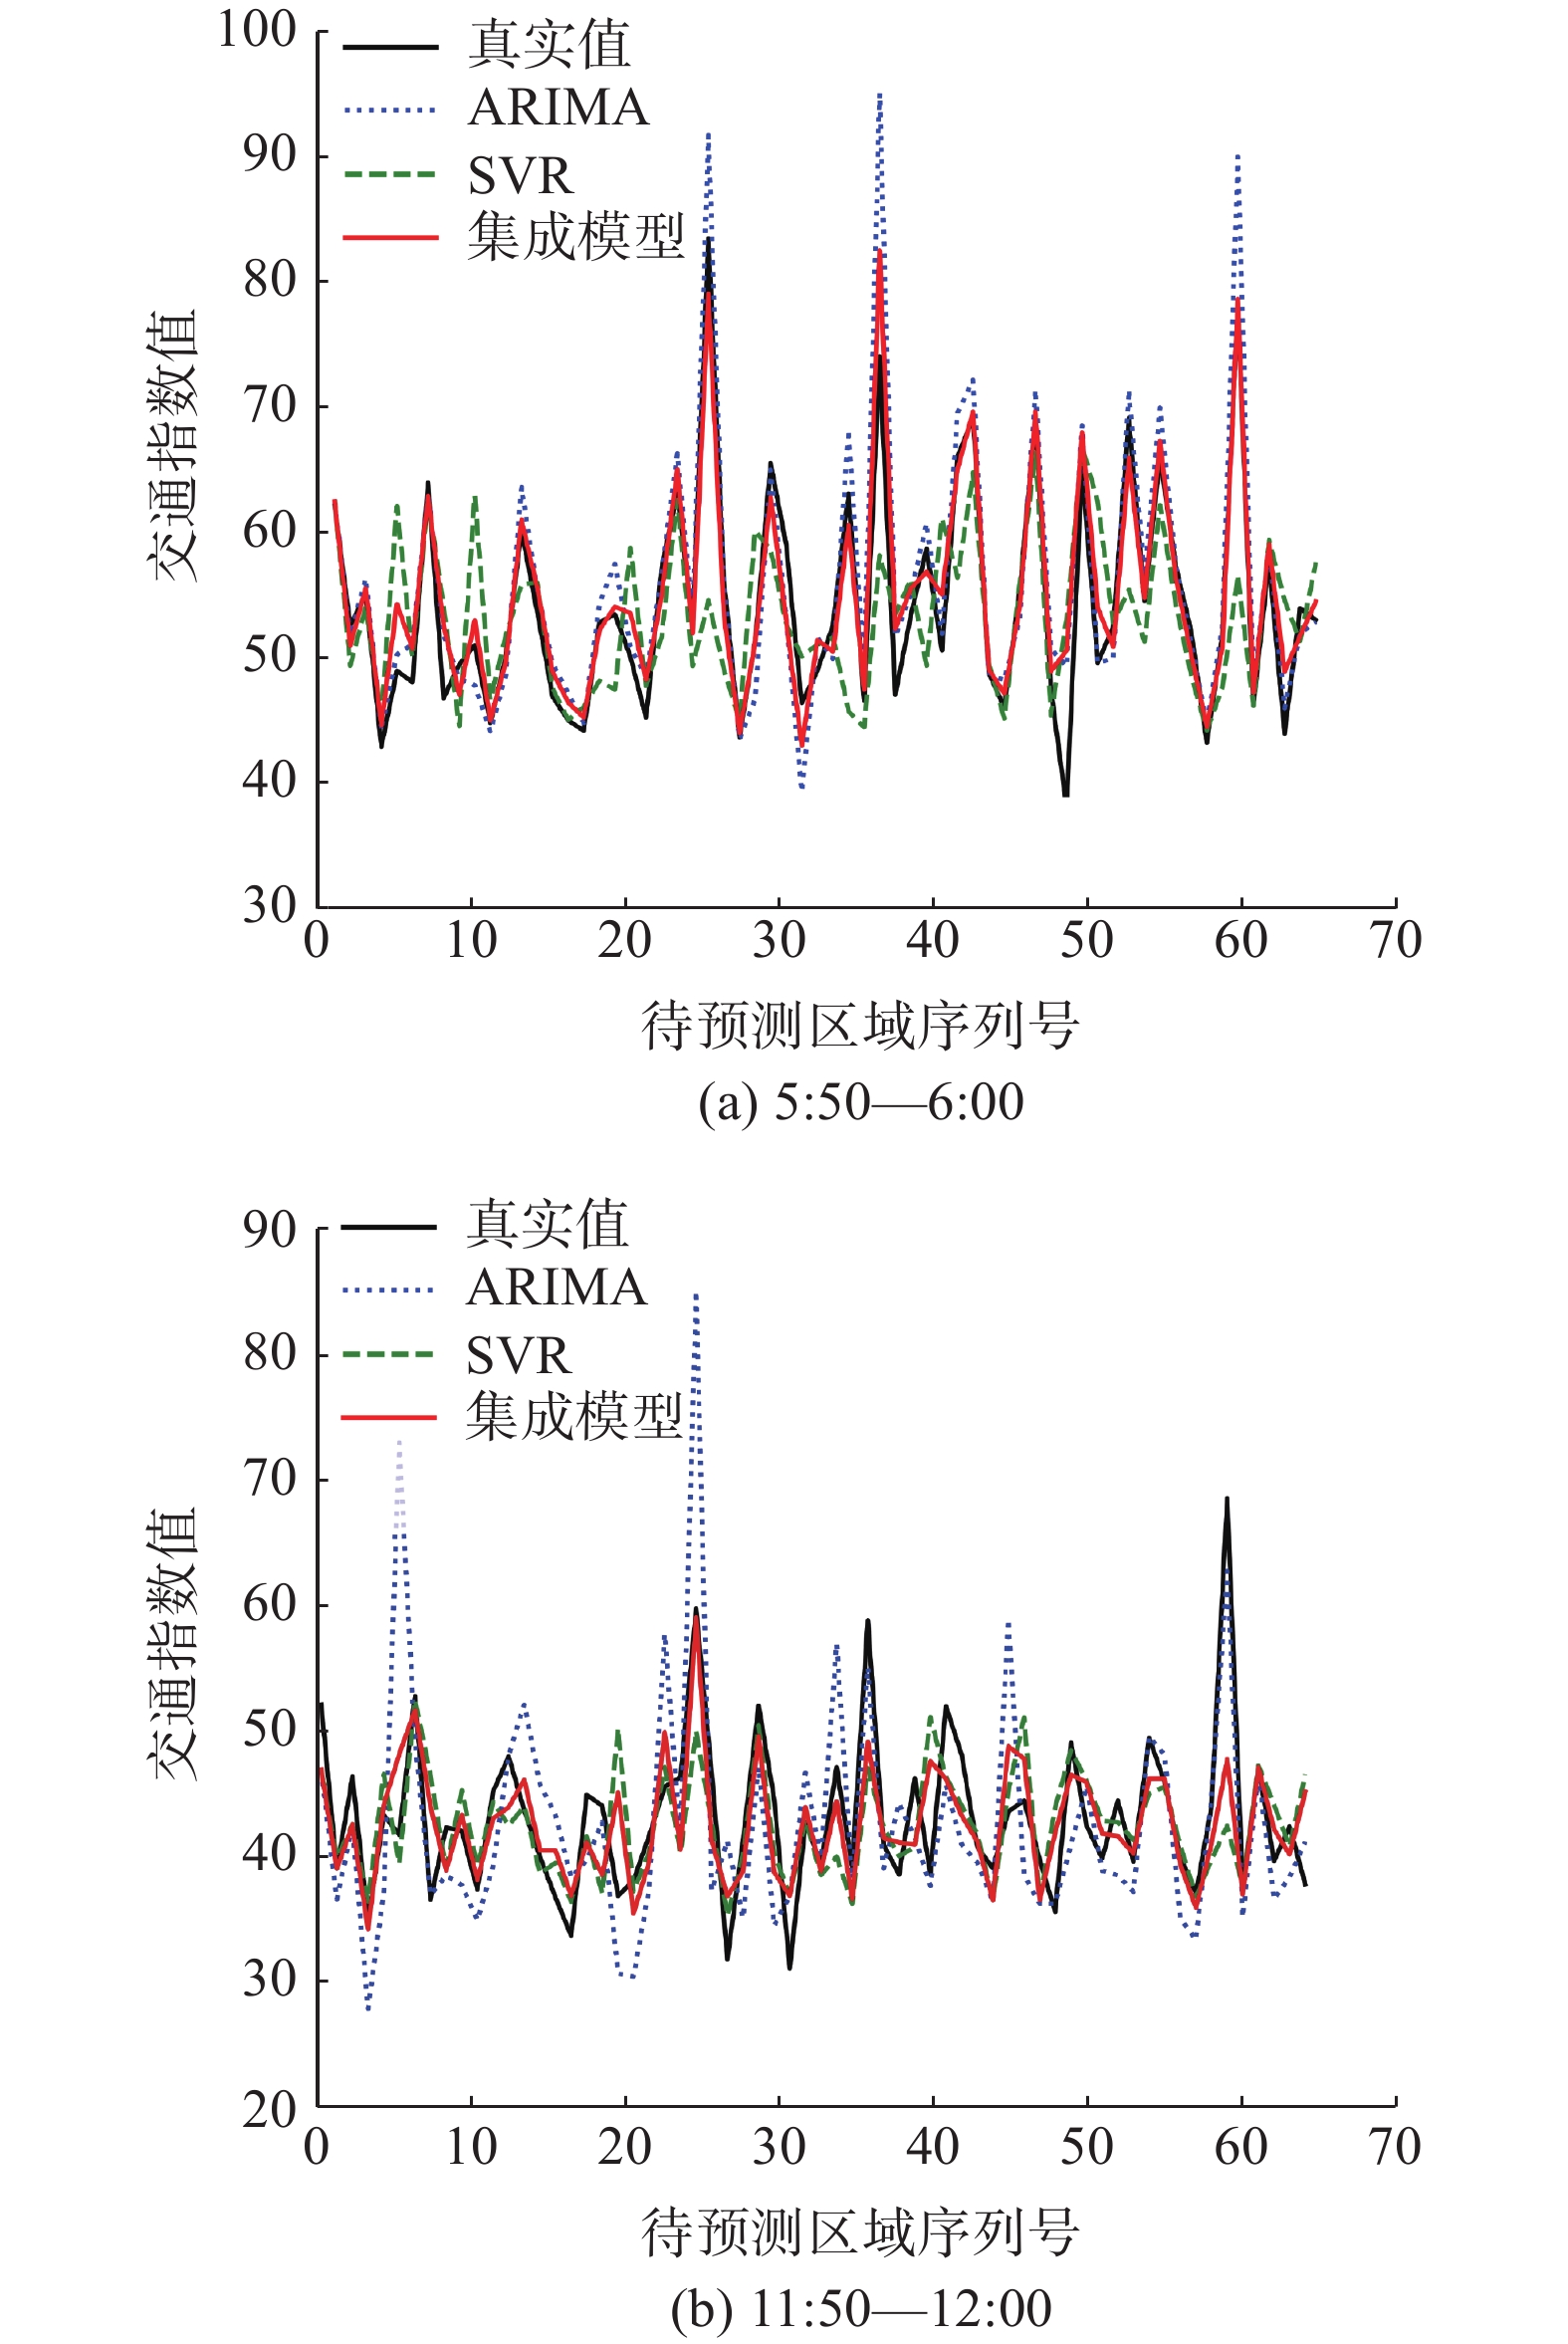
图7显示了集成模型预测的值,以及其与ARIMA和SVR以及真实值进行对比的结果。可以看出,集成模型对真实值的拟合效果更好,并且对于一些峰值点也能有更准确的预测效果。评价指标对比结果如表2和表3所示,从指标值中可以看出,ARIMA和SVR在2个不同时间段的表现确实相差较大。在5:50—6:00时间段,ARIMA模型的性能明显优于SVR模型的性能;而在11:50—12:00时间段,SVR模型的性能明显优于ARIMA模型的性能。
|
图 7 3种模型与真实值对比结果 Fig. 7 Comparison between the predicted value of three models and true value |
|
|
表 2 5:50—6:00时3个模型的评价指标值 Table 2 Evaluation indicators of three models during the time period from 5:50 to 6:00 |
|
|
表 3 11:50—12:00时3个模型的评价指标值 Table 3 Evaluation indicators of three models during the time period from 11:50 to 12:00 |
上述结果对比说明了交通流的变化是一个未知且复杂的过程,只从一个角度,用一种模型进行分析,很难得到理想的效果,这就体现了构建集成模型的必要性。时间预测模型与空间预测模型各有其优劣,它们各自的预测性能可能受预测时间、早高峰、异常拥堵区域、模型学习过程等诸多因素影响,并不存在一种模型优于另一种的情况。因此,对于集成模型来说,参数设置是否合理对最终结果有重要影响,否则,得到的结果甚至会不如单个时间或空间模型的结果。
需要强调的是,本文提出的集成模型是一种用于指数云图类预测问题的框架,所用的时间预测模型和空间预测模型可根据实际情况进行选择,并不局限于文中提到的模型。实验部分的设计也是为了模拟在一个较坏的情况下各模型间性能的对比。在实际情况中出现大范围指数值缺失的情况较少,因此,模型的性能也应该更好。
3.4 集成模型参数对效果的影响集成模型性能好坏的关键在于参数的确定,如果集成模型的参数未按照文中提出的自适应方法进行学习,而是用经验方法人为确定,那么,模型的效果会显著下降。表4和表5呈现了评价指标MAE随集成模型参数取值不同对应的结果。表中前3列的参数是根据经验选取的,最后1列的参数是根据自适应方法学习得到的。可以看出,根据经验选取的参数值对应的MAE都比自适应方法得到的大,说明在不同的时间段,自适应方法得到的参数总能取得相对较好的预测结果。此外,在5:50—6:00时间段,
|
|
表 4 5:50—6:00不同模型参数对应的MAE值 Table 4 MAE values corresponding to different model parameters during the time period from 5:50 to 6:00 |
|
|
表 5 11:50—12:00不同模型参数对应的MAE值 Table 5 MAE values corresponding to different model parameters during the time period from 11:50 to 12:00 |
以交通指数为基础进行了区域交通状态预测研究,将现有的中微观层面的交通流预测方法运用到了宏观层面。通过从时间与空间2个维度进行预测分析,提出了一种适用于云图类预测问题的时空结合集成模型框架。在交通指数云图上进行的实验表明,单独的时间或空间预测模型性能各有其不足,而自适应的集成模型弥补了它们的缺陷,并且得到的结果更为精确。
本文的研究主要以交通指数云图为依据,交通指数云图具有原创性,因此,较难找到这方面的实验对比方法。在后续研究中,将围绕所提出的集成模型框架,将更多的时间和空间预测方法代入,进行充分的实验和对比分析,以进一步阐明集成模型的合理性,并进一步提高预测结果的准确率。
| [1] |
LO S C, HSU C H. Cellular automata simulation for mixed manual and automated control traffic[J]. Mathematical and Computer Modelling, 2010, 51(7/8): 1000-1007. |
| [2] |
HOOGENDOORN S P, BOVY P H L. State-of-the-art of vehicular traffic flow modelling[J]. Proceedings of the Institution of Mechanical Engineers, Part I:Journal of Systems and Control Engineering, 2001, 215(4): 283-303. DOI:10.1177/095440890121500403 |
| [3] |
LI Y N, XIAO J L. Traffic peak period detection using traffic index cloud maps[J]. Physica A: Statistical Mechanics and its Applications, 2020, 553: 124277. DOI:10.1016/j.physa.2020.124277 |
| [4] |
肖建力. 智能交通中的多核支持向量机与分类器集成方法研究[D]. 上海: 上海交通大学, 2013: 88–94.
|
| [5] |
XIAO J L, LI H, WANG X, et al. Traffic peak period detection from an image processing view[J]. Journal of Advanced Transportation, 2018, 2018: 2097932. |
| [6] |
MORI U, MENDIBURU A, ÁLVAREZ M, et al. A review of travel time estimation and forecasting for advanced traveller information systems[J]. Transportmetrica A: Transport Science, 2015, 11(2): 119-157. DOI:10.1080/23249935.2014.932469 |
| [7] |
WONG K I, HSIEH Y C. Short-term traffic flow forecasting for urban roads using space-time ARIMA[C]//15th International Conference of Hong Kong Society for Transportation Studies. Hong Kong, China, 2010: 583–584.
|
| [8] |
LI L C, HE S L, ZHANG J, et al. Short-term highway traffic flow prediction based on a hybrid strategy considering temporal-spatial information[J]. Journal of Advanced Transportation, 2016, 50(8): 2029-2040. DOI:10.1002/atr.1443 |
| [9] |
BOX G E P, JENKINS G M, REINSEL G C. Time series analysis: forecasting and control[M]. Hoboken, New Jersey: John Wiley & Sons, 2011
|
| [10] |
YU C Y, LAM K C. Applying multiple kernel learning and support vector machine for solving the multicriteria and nonlinearity problems of traffic flow prediction[J]. Journal of Advanced Transportation, 2014, 48(3): 250-271. DOI:10.1002/atr.1217 |
| [11] |
WU C H, HO J M, LEE D T. Travel-time prediction with support vector regression[J]. IEEE Transactions on Intelligent Transportation Systems, 2004, 5(4): 276-281. DOI:10.1109/TITS.2004.837813 |
| [12] |
FENG X X, LING X Y, ZHENG H F, et al. Adaptive multi-kernel SVM with spatial-temporal correlation for short-term traffic flow prediction[J]. IEEE Transactions on Intelligent Transportation Systems, 2019, 20(6): 2001-2013. DOI:10.1109/TITS.2018.2854913 |
| [13] |
XU D W, WANG Y D, JIA L M, et al. Real-time road traffic state prediction based on ARIMA and Kalman filter[J]. Frontiers of Information Technology & Electronic Engineering, 2017, 18(2): 287-302. |
| [14] |
LUO X L, NIU L Y, ZHANG S R. An algorithm for traffic flow prediction based on improved SARIMA and GA[J]. KSCE Journal of Civil Engineering, 2018, 22(10): 4107-4115. DOI:10.1007/s12205-018-0429-4 |
| [15] |
CHAPELLE O, VAPNIK V, BOUSQUET O, et al. Choosing multiple parameters for support vector machines[J]. Machine Learning, 2002, 46(1/3): 131-159. DOI:10.1023/A:1012450327387 |
| [16] |
LI Z, YUAN R, GUAN X. Accurate classification of the internet traffic based on the svm method[C]//2007 IEEE International Conference on Communications. Glasgow, UK: IEEE, 2007: 1373–1378.
|
| [17] |
WANG H Y, WANG Y Z. Vessel traffic flow forecasting with the combined model based on support vector machine[C]// 2015 International Conference on Transportation Information and Safety. Wuhan, China: IEEE, 2015: 695–698.
|
| [18] |
ESTE A, GRINGOLI F, SALGARELLI L. Support vector machines for TCP traffic classification[J]. Computer Networks, 2009, 53(14): 2476-2490. DOI:10.1016/j.comnet.2009.05.003 |
| [19] |
JING N, YANG M, CHENG S Y, et al. An efficient SVM-based method for multi-class network traffic classification[C]//30th IEEE International Performance Computing and Communications Conference. Orlando, FL, USA: IEEE, 2011: 1–8.
|
| [20] |
HONG W C, DONG Y C, ZHENG F F, et al. Hybrid evolutionary algorithms in a SVR traffic flow forecasting model[J]. Applied Mathematics and Computation, 2011, 217(15): 6733-6747. DOI:10.1016/j.amc.2011.01.073 |
| [21] |
LUO X L, LI D Y, ZHANG S R. Traffic flow prediction during the holidays based on DFT and SVR[J]. Journal of Sensors, 2019, 2019: 6461450. |
| [22] |
XIAO J L, LIU Y C. Traffic incident detection using multiple-kernel support vector machine[J]. Transportation Research Record, 2012, 2324(1): 44-52. DOI:10.3141/2324-06 |
| [23] |
XIAO J L. SVM and KNN ensemble learning for traffic incident detection[J]. Physica A:Statistical Mechanics and its Applications, 2019, 517: 29-35. DOI:10.1016/j.physa.2018.10.060 |
| [24] |
XIAO J L, WANG Z H. Traffic speed cloud maps: a new method for analyzing macroscopic traffic flow[J]. Physica A: Statistical Mechanics and its Applications, 2018, 508: 367-375. DOI:10.1016/j.physa.2018.05.122 |
| [25] |
KAVOUSI-FARD A, KAVOUSI-FARD F. A new hybrid correction method for short-term load forecasting based on ARIMA, SVR and CSA[J]. Journal of Experimental & Theoretical Artificial Intelligence, 2013, 25(4): 559-574. |
| [26] |
JAHN J. Karush−Kuhn−Tucker conditions in set optimization[J]. Journal of Optimization Theory and Applications, 2017, 172(3): 707-725. DOI:10.1007/s10957-017-1066-7 |
| [27] |
ZHANG L Z, ALHARBE N R, LUO G C, et al. A hybrid forecasting framework based on support vector regression with a modified genetic algorithm and a random forest for traffic flow prediction[J]. Tsinghua Science and Technology, 2018, 23(4): 479-492. DOI:10.26599/TST.2018.9010045 |
| [28] |
GENUER R, POGGI J M, TULEAU-MALOT C. Variable selection using random forests[J]. Pattern Recognition Letters, 2010, 31(14): 2225-2236. DOI:10.1016/j.patrec.2010.03.014 |